Zwei grundsätzliche Ansätze
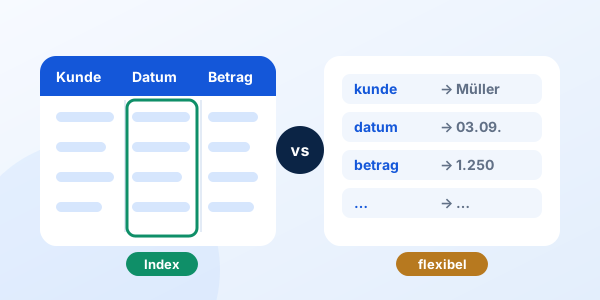
Moderne ECM-Systeme speichern Metadaten in der Regel auf zwei Arten: in klassischen relationalen Datenbanktabellen oder als pauschale Schlüssel-Wert-Paare.
1. Klassische relationale Datenbanktabellen
Hier wird jedes Dokument in einer strukturierten Tabelle gespeichert. Jedes Metadatenfeld besitzt eine eigene Spalte. Auf diesen Feldern können Datenbank-Indizes angelegt werden.
2. Key/Value-Speicherung
Bei diesem Ansatz werden Metadaten als Schlüssel-Wert-Paare gespeichert. Technisch wirkt das zunächst flexibel, weil neue Metadatenfelder ohne Anpassung der Datenbank angelegt werden können.
Warum echte Tabellen häufig performanter sind
Bei strukturierten Datenbanktabellen kann die Datenbank gezielt Indizes nutzen. Sucht ein Anwender beispielsweise nach Kunde, Datum und Betrag, wird die Suche direkt über die indizierten Felder ausgeführt.
Bei Key/Value-Modellen muss die Datenbank hingegen häufig deutlich mehr Datensätze durchsuchen und mehrere Tabellenverknüpfungen durchführen. Der Unterschied wird sichtbar, wenn mehrere Millionen Dokumente archiviert sind, komplexe Suchabfragen entstehen, viele Benutzer gleichzeitig arbeiten oder KI-Anwendungen auf Metadaten zugreifen.
Die Flexibilität von Key/Value-Systemen
Key/Value-Strukturen haben ihre Berechtigung. Sie ermöglichen schnelle Anpassungen von Aktenstrukturen, individuelle Metadaten je Dokumenttyp und geringeren Administrationsaufwand bei Änderungen. Für kleinere Installationen oder sehr dynamische Anwendungsfälle kann dieser Ansatz sinnvoll sein.
Das KI-Zeitalter verändert die Anforderungen
KI-Anwendungen benötigen große Mengen sauber strukturierter Metadaten für semantische Suche, Retrieval Augmented Generation (RAG), automatische Klassifizierung, Prozessanalysen und Datenqualitätsprüfungen. Je strukturiierter die Daten gespeichert sind, desto einfacher können KI-Modelle darauf zugreifen und Zusammenhänge erkennen.
Worauf Unternehmen achten sollten
- Werden Metadaten in echten Datenbanktabellen gespeichert?
- Können auf Felder individuelle Datenbank-Indizes angelegt werden?
- Wie verhält sich die Performance bei mehreren Millionen Dokumenten?
- Gibt es Referenzen mit vergleichbaren Datenmengen?
- Wie unterstützt die Architektur zukünftige KI-Anwendungen?
Fazit
Die Speicherung von Metadaten ist kein technisches Detail, sondern eine strategische Entscheidung. Key/Value-Strukturen bieten maximale Flexibilität, relationale Datenbanktabellen punkten mit Performance, Skalierbarkeit und einer starken Grundlage für zukünftige KI-Anwendungen.
Redaktionelle Einordnung des ECM-Radar. Die konkrete Architektur und belastbare Lastwerte sollten im Auswahlprozess beim jeweiligen Anbieter validiert werden.